Comprendre le fonctionnement des modèles conversationnels : du prompt à la réponse
- Un modèle conversationnel, qu'est-ce que c'est ?
- Le prompt : la matière première de la réponse
- De la phrase aux tokens : comment le texte devient exploitable
- Le rôle de l'attention dans la compréhension du contexte
- Pourquoi la réponse apparaît-elle mot après mot ?
- L'entraînement, puis l'alignement des réponses
- Les erreurs fréquentes : hallucinations, biais et contexte incomplet
- Construire une demande qui donne une réponse exploitable
- Ce que les modèles conversationnels font bien, et moins bien
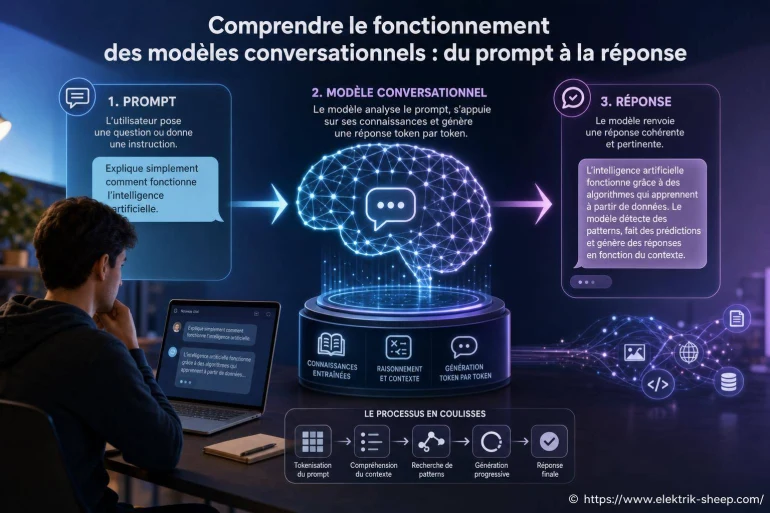
Un modèle conversationnel transforme votre demande en une suite de mots probable, construite à partir de ce qu'il a appris durant son entraînement et du contexte disponible dans l'échange. Derrière une réponse fluide, il n'y a pas une pensée humaine cachée, mais une chaîne d'opérations : lecture du message, découpage en unités de texte, interprétation du contexte, calcul de probabilités, puis génération progressive.
Comprendre le fonctionnement des modèles conversationnels : du prompt à la réponse aide à mieux utiliser des outils comme ChatGPT, Gemini ou DeepSeek, que ce soit pour rédiger, programmer, apprendre ou préparer une quête, un dialogue ou un univers de jeu. Une bonne demande ne garantit pas une vérité absolue ; elle donne surtout au modèle des repères plus précis pour produire une réponse utile.
Un modèle conversationnel, qu'est-ce que c'est ?
Un modèle conversationnel est un programme d'intelligence artificielle conçu pour traiter et générer du langage. Il reçoit un texte, repère des relations entre les mots et produit une continuation cohérente avec la question, les consignes et les messages précédents. Son principe central est simple à formuler : il prédit, étape après étape, quel élément de texte a le plus de chances de suivre.
Le terme modèle de langage désigne l'architecture mathématique et les paramètres issus de l'entraînement. Ces paramètres ne sont pas une bibliothèque de phrases rangées dans des tiroirs. Ils correspondent plutôt à une immense carte de relations statistiques : associations entre notions, structures de phrases, styles, langues, raisonnements fréquemment rencontrés et façons de répondre à des questions.
Imaginez un improvisateur qui aurait lu une quantité gigantesque de textes : il ne récite pas forcément une page mémorisée, il construit sa réplique en tenant compte de la scène, du ton et de la dernière phrase prononcée.
Cette mécanique explique à la fois la force et la limite de ces outils. Ils peuvent reformuler un texte, proposer une stratégie de build pour un jeu de rôle ou expliquer un concept difficile avec une aisance remarquable. Mais une formulation convaincante n'est pas une preuve : le modèle peut aussi produire une information erronée, imprécise ou inventée lorsqu'il manque de données fiables dans son contexte.
À ne pas rater également
Le prompt : la matière première de la réponse
Le prompt est le message envoyé au modèle. Une question courte comme « Explique-moi Elden Ring » laisse une grande marge d'interprétation. Une demande plus cadrée - « Explique les principes du combat d'Elden Ring à un débutant, en cinq points, sans révéler l'histoire » - fournit un objectif, un public, un format et une limite claire.
Le modèle ne lit pas vos intentions implicites comme le ferait un proche ou un collègue. Il s'appuie sur les mots effectivement présents dans la conversation. Chaque précision utile réduit les ambiguïtés : le niveau de détail attendu, le ton, la langue, les contraintes, le public visé et les éléments à exclure.
Le rôle
Indiquer un angle aide à calibrer la réponse : professeur, testeur, scénariste, analyste ou assistant de support.
La tâche
Le verbe compte : comparer, résumer, corriger, expliquer, proposer ou traduire ne sollicitent pas le même résultat.
Le contexte
Un extrait, des règles maison, une liste de personnages ou une plateforme de jeu évitent les suppositions inutiles.
Le format
Liste, tableau, script de dialogue, plan de quête ou code commenté : le livrable devient plus facile à exploiter.
Une demande utile peut donc ressembler à ceci : « Crée trois idées de quêtes secondaires pour un jeu de science-fiction. Chaque quête doit tenir en quatre lignes, proposer un dilemme moral et ne pas nécessiter de combat. » Le résultat reste à évaluer, mais les critères de sortie sont déjà nettement plus solides.

De la phrase aux tokens : comment le texte devient exploitable
Avant de traiter une demande, le modèle la découpe en tokens. Un token est une unité de texte : il peut correspondre à un mot entier, une partie de mot, un signe de ponctuation ou parfois un espace selon le système employé. Ce découpage permet de convertir le langage en nombres manipulables par le réseau de neurones.
La phrase « Trouve une idée de boss » n'est donc pas absorbée comme une phrase au sens humain du terme. Elle devient une suite d'identifiants numériques. À chacun est associée une représentation mathématique qui aide le modèle à situer son sens et ses liens possibles avec les autres éléments du message.
Cette étape a une conséquence concrète : les modèles travaillent avec une fenêtre de contexte, c'est-à-dire une quantité limitée de texte qu'ils peuvent prendre en compte à la fois. Quand une conversation devient très longue, certains éléments anciens peuvent perdre en influence, ne plus être disponibles ou être résumés selon l'outil utilisé.
| Étape | Ce que fait le système | Effet visible pour l'utilisateur |
|---|---|---|
| Tokenisation | Découpe le texte en unités manipulables. | La longueur et la formulation du message comptent. |
| Lecture du contexte | Relie la demande aux messages précédents et aux consignes actives. | Une conversation bien structurée produit des réponses plus cohérentes. |
| Prédiction | Évalue les suites de texte possibles. | La réponse est générée progressivement, et non d'un seul bloc. |
| Décodage | Sélectionne un token, puis recommence jusqu'à la fin. | Les réglages influencent le ton, la diversité et la stabilité du résultat. |
Le rôle de l'attention dans la compréhension du contexte
La plupart des modèles conversationnels modernes reposent sur une architecture dite Transformer. Son mécanisme le plus connu, l'attention, permet au système d'évaluer quelles parties du contexte sont les plus pertinentes pour interpréter un mot ou produire la suite d'un texte.
Dans la phrase « Le mage a donné son bâton au guerrier parce qu'il était cassé », le pronom « il » peut désigner le mage, le guerrier ou le bâton selon le contexte. L'attention aide le modèle à peser les éléments susceptibles de résoudre cette ambiguïté. Elle n'offre pas une compréhension humaine du récit, mais elle améliore fortement la capacité à maintenir des relations entre des mots éloignés.
Pour les usages liés au jeu vidéo, cela permet par exemple de conserver le nom d'une faction, les règles d'un système de combat ou le caractère d'un PNJ sur plusieurs échanges. La cohérence n'est jamais garantie : si les informations sont contradictoires, floues ou très nombreuses, le modèle peut mélanger les détails. Répéter les contraintes essentielles reste alors une bonne pratique.
Pourquoi la réponse apparaît-elle mot après mot ?
Une fois le contexte analysé, le modèle attribue une probabilité à de nombreux tokens possibles. Il en sélectionne un, l'ajoute à la réponse, puis utilise cette réponse partielle comme nouveau contexte pour choisir le token suivant. C'est pourquoi une réponse se construit progressivement à l'écran.
La sélection n'est pas toujours le choix du token le plus probable. Selon les réglages, le système peut introduire davantage de variété pour éviter des formulations trop répétitives. Une génération très prudente favorise la stabilité et les réponses prévisibles ; une génération plus libre peut offrir des idées originales, au prix d'un risque plus élevé d'incohérence. [ Voir ici aussi ]
Dans les interfaces grand public, d'autres couches peuvent intervenir autour du modèle : recherche sur le web, lecture de fichiers, exécution de code, accès à une base documentaire ou filtres de sécurité. Dans ce cas, la réponse finale peut combiner le texte généré avec des informations récupérées par un outil externe. Cela ne rend pas automatiquement le résultat exact : il faut encore vérifier la qualité des sources et la manière dont elles sont interprétées.
L'entraînement, puis l'alignement des réponses
Un modèle est d'abord entraîné sur de vastes ensembles de textes afin d'apprendre à prédire la suite d'une séquence. Durant cette phase, il repère des régularités dans la langue, les formats, le vocabulaire et les associations entre sujets. Il ne consulte pas nécessairement ces données au moment de répondre : une partie de ce qu'il a appris est encodée dans ses paramètres.
Vient ensuite une phase d'ajustement destinée à obtenir des échanges plus utiles et plus sûrs. Des exemples de questions et de réponses, ainsi que des évaluations humaines ou automatisées, peuvent aider à orienter le comportement du système. C'est ce qui pousse un assistant à suivre une consigne de format, à refuser certains contenus ou à signaler une incertitude.
Ces garde-fous ne sont pas parfaits. Le modèle peut mal comprendre une demande, surinterpréter un passage ou se montrer trop affirmatif. Il reste donc préférable d'utiliser l'IA comme un interlocuteur de travail : utile pour accélérer une première version, explorer des options ou clarifier une notion, mais pas comme une autorité incontestable.
Les erreurs fréquentes : hallucinations, biais et contexte incomplet
Une hallucination désigne une réponse inventée ou erronée présentée comme plausible. Le mot est imagé : le modèle ne perçoit pas une réalité inexistante, il génère une suite de texte qui paraît cohérente sans disposer d'un fondement suffisant. Il peut inventer le nom d'un studio, attribuer une mécanique à un jeu ou fabriquer une référence qui sonne juste.
Ce risque augmente lorsqu'on demande un détail rare, une actualité non fournie au modèle, une citation précise ou une information très spécialisée. Il augmente aussi lorsque la demande pousse à répondre à tout prix. Formuler « Si l'information n'est pas certaine, dis-le clairement » peut encourager davantage de prudence, sans éliminer le besoin de vérification.
- Vérifiez les noms propres, dates, chiffres et citations avant de les publier.
- Demandez au modèle de distinguer les faits, les hypothèses et les idées créatives.
- Fournissez les documents ou extraits nécessaires quand la précision dépend d'une source donnée.
- Scindez une tâche complexe en étapes lorsque les contraintes sont nombreuses.
- Relisez le résultat comme vous reliriez le travail d'un collaborateur rapide, mais imparfait.
Les biais méritent la même attention. Les données d'entraînement reflètent des choix éditoriaux, des stéréotypes, des déséquilibres culturels et des erreurs présentes dans les textes disponibles. Une consigne précise, une relecture attentive et la confrontation de plusieurs sources réduisent le risque de laisser passer une représentation caricaturale ou une généralisation abusive.
Construire une demande qui donne une réponse exploitable
La meilleure approche consiste à avancer par itérations. Commencez par une tâche claire, observez la réponse, puis ajoutez ce qui manque. Vous pouvez demander une version plus courte, exiger une structure différente, corriger une information ou imposer une contrainte de ton. L'échange sert précisément à affiner le résultat.
- Définissez le résultat attendu. Voulez-vous un synopsis, une explication, une liste de mécaniques ou un script ?
- Ajoutez le contexte indispensable. Donnez le genre du jeu, le public, les règles déjà fixées et les informations non négociables.
- Fixez les limites. Mentionnez la longueur, les spoilers interdits, les sujets à éviter ou les sources à utiliser.
- Demandez une forme lisible. Un tableau, des puces ou des sections nommées facilitent la relecture.
- Contrôlez et corrigez. Signalez précisément ce qui ne convient pas plutôt que de repartir d'une demande vague.
Pour créer un personnage, par exemple, « Invente un antagoniste » produit souvent une proposition générique. « Imagine un antagoniste pour un jeu d'enquête cyberpunk : ancien journaliste, motivé par une affaire étouffée, sans pouvoir surnaturel, avec un objectif compréhensible mais des méthodes dangereuses. Donne sa présentation, son secret et deux scènes de confrontation » donne au modèle une scène beaucoup mieux définie.
Le gain n'est pas seulement stylistique. Un contexte précis limite les contradictions et rend plus simple la vérification du résultat. Vous savez quelles conditions la réponse devait respecter, donc vous repérez immédiatement ce qui s'en écarte.
Ce que les modèles conversationnels font bien, et moins bien
Les modèles conversationnels sont particulièrement utiles pour reformuler, résumer un document fourni, générer des variantes, expliquer une notion à plusieurs niveaux de difficulté, préparer un plan ou produire une première ébauche. Dans un cadre créatif, ils peuvent aussi aider à débloquer une idée de puzzle, proposer des lignes de dialogue ou décliner une même mission selon plusieurs factions.
Ils sont moins fiables quand une réponse exige une information exacte, récente, confidentielle ou absente du contexte. Ils ne remplacent pas un test en jeu, une lecture complète de documentation, une expertise professionnelle ni la consultation d'une source primaire. Leur capacité à écrire naturellement masque parfois cette frontière.
Le réflexe le plus utile consiste à séparer deux usages : la génération, où l'on cherche des pistes, et la validation, où l'on contrôle les faits. Pour une quête fictive, une réponse inventive peut être une qualité. Pour une commande technique ou une information de patch, la précision doit passer avant le style.
Un bon dialogue avec l'IA ressemble donc moins à une question posée à un oracle qu'à une collaboration structurée. Donnez un cadre, demandez des justifications quand elles sont nécessaires, confrontez le résultat à des sources solides et gardez la main sur les décisions finales. C'est à ce moment-là que la réponse générée devient réellement utile : non parce qu'elle est automatique, mais parce qu'elle s'inscrit dans un travail de vérification, de choix et de création.


A propos de nous : Pixelina RAM

Je suis Pixelina RAM, une exploratrice intrépide des mondes numériques et des pixels animés. Depuis toute petite, je me passionne pour les univers vidéoludiques, des classiques rétro aux dernières nouveautés indé. J’adore décortiquer la narration, analyser les mécaniques de jeu et partager mes coups de cœur insolites. Sur Elektrik Sheep, je vous invite à me suivre dans des aventures où la curiosité et l’émerveillement sont toujours au rendez-vous. Préparez vos manettes, on ne sait jamais où la prochaine quête nous emmènera !