Reka AI : une IA multimodale optimisée pour la performance GPU
- Reka Ai : comprendre son positionnement
- Ia Multimodale : texte, image et vidéo dans le même échange
- Performance Gpu : pourquoi l'efficacité change l'expérience
- Indépendante : une alternative dans l'écosystème des modèles
- Des usages concrets pour le jeu vidéo et la création
- Comment évaluer un modèle multimodal dans la pratique ?
- Ce que la recherche d'efficacité implique réellement
-
Questions fréquentes
- Qu'est-ce que Reka AI ?
- Que signifie IA multimodale ?
- Pourquoi les GPU sont-ils essentiels pour ces modèles ?
- Reka AI peut-il analyser du gameplay ?
- La performance GPU signifie-t-elle seulement une réponse plus rapide ?
- Comment tester la qualité d'un modèle multimodal ?
- Un modèle multimodal peut-il se tromper sur une image ?
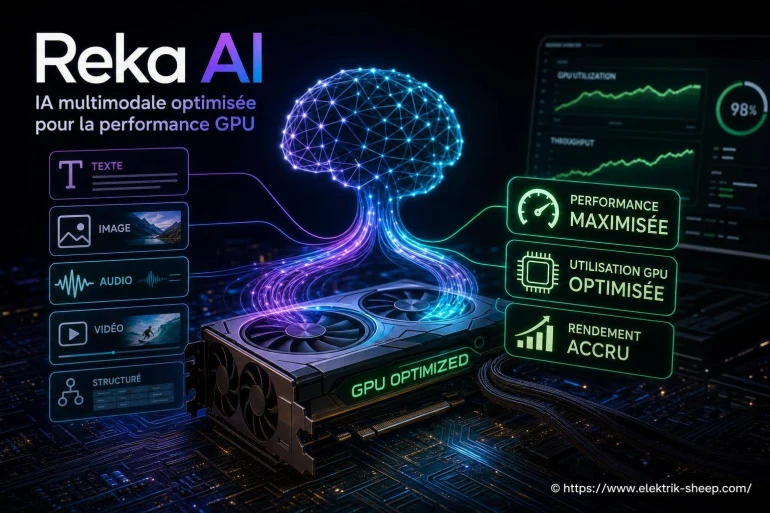
Reka AI : IA multimodale optimisée pour la performance GPU désigne une famille de modèles capables d'interpréter plusieurs types de contenus, notamment le texte, les images et la vidéo. Son intérêt tient autant à ses capacités de compréhension qu'à sa recherche d'efficacité matérielle : pour les usages interactifs, la vitesse d'inférence sur GPU compte presque autant que la qualité de la réponse.
Pour les créateurs, les joueurs et les équipes qui manipulent des séquences visuelles, Reka AI illustre une direction claire : une IA ne doit pas seulement décrire une image, mais saisir l'action, le contexte et les relations entre les éléments d'une scène. Cette approche ouvre des usages concrets, de l'analyse de gameplay au sous-titrage, en passant par l'assistance à la création.
Reka Ai : comprendre son positionnement
Reka AI est une entreprise spécialisée dans les modèles d'intelligence artificielle multimodaux. Un modèle multimodal traite plusieurs formats d'information au sein d'un même raisonnement : une question écrite peut être reliée à une image, à une suite d'images ou à une vidéo.
La société a notamment présenté des modèles comme Reka Core, destiné aux tâches complexes, ainsi que des modèles plus légers adaptés à des contraintes de latence ou de coût. L'idée n'est pas simplement d'empiler des fonctions de vision et de texte : le système vise à relier les indices visuels à une instruction écrite afin de produire une réponse contextualisée.
Une IA multimodale utile ne se contente pas de « voir » une scène : elle doit comprendre ce qui s'y passe, ce qui a changé et ce que l'utilisateur cherche à vérifier.
Dans un extrait de jeu, cette nuance est essentielle. Identifier une arme à l'écran est une tâche de reconnaissance. Expliquer pourquoi une action a échoué, repérer l'instant où un adversaire apparaît ou résumer une séquence de combat demande une lecture plus riche de la vidéo.
À ne pas rater également
Ia Multimodale : texte, image et vidéo dans le même échange
L'IA multimodale associe différentes sources de données dans une conversation unique. Au lieu de décrire laborieusement une capture d'écran, l'utilisateur peut la fournir avec sa question. Le modèle s'appuie alors sur les pixels, le texte visible et la formulation de la demande.
Comprendre une image
Une capture de gameplay peut servir à identifier une interface, un objectif, une erreur de placement ou un détail de décor difficile à repérer.
Lire une vidéo
Une séquence permet de suivre une action dans le temps : déplacement, animation, changement de caméra ou succession d'événements.
Répondre en langage naturel
La réponse peut prendre la forme d'une explication, d'un résumé, d'une liste d'étapes ou d'une comparaison directement exploitable.
La vidéo reste le format le plus exigeant. Elle contient une succession d'images, mais aussi une temporalité : un objet apparaît, disparaît, change d'état ou interagit avec un autre élément. Pour limiter le coût de calcul, les modèles doivent sélectionner les informations pertinentes plutôt que traiter chaque image avec le même niveau d'attention.
Cette logique rejoint les outils de création générative. Ceux qui expérimentent Runway Gen-3 pour la génération vidéo avancée voient déjà l'importance des descriptions précises, des mouvements cohérents et de la lecture des plans. Les modèles de compréhension multimodale se situent de l'autre côté du flux : ils analysent ce qui est montré au lieu de le produire.
Performance Gpu : pourquoi l'efficacité change l'expérience
Le GPU, ou processeur graphique, est au cœur du fonctionnement des grands modèles d'IA. Il exécute en parallèle de nombreux calculs matriciels, une force particulièrement adaptée aux réseaux de neurones. La performance ne se résume pas à un score brut : elle concerne aussi la mémoire disponible, la latence et le nombre de requêtes traitées simultanément.
Dans une utilisation quotidienne, une faible latence est visible immédiatement. Si l'analyse d'une capture ou d'un court clip demande trop longtemps, l'outil devient moins naturel. À l'inverse, une réponse rapide favorise les échanges successifs : demander une première lecture, signaler un détail, puis affiner l'analyse.
Les modèles compacts ont un rôle important dans cette équation. Ils ne remplacent pas systématiquement les modèles les plus puissants, mais ils peuvent être mieux adaptés à une tâche ciblée : filtrer des images, classer des extraits, extraire une information précise ou assister un utilisateur en direct.
- Réduire le délai avant la première réponse dans une interface conversationnelle.
- Analyser davantage de contenus visuels avec une même enveloppe de calcul.
- Déployer des services capables d'absorber des demandes simultanées.
- Choisir un modèle proportionné à la complexité réelle de la tâche.
Indépendante : une alternative dans l'écosystème des modèles
Le statut d'entreprise indépendante donne à Reka AI une place particulière dans un marché dominé par de très grands groupes technologiques. Cette position ne garantit pas à elle seule de meilleures performances, mais elle peut favoriser des choix de produit plus ciblés et une recherche concentrée sur des modèles spécialisés.
Pour les développeurs, la diversité des acteurs est utile. Elle évite de réduire les choix à une poignée de plateformes et encourage la comparaison entre plusieurs compromis : taille des modèles, qualité de vision, vitesse de réponse, coût d'exploitation et modes d'intégration.
Le bon modèle dépend du besoin. Une analyse longue et nuancée d'une vidéo narrative ne réclame pas les mêmes ressources qu'un contrôle simple sur des centaines de captures. Tester sur ses propres exemples reste plus parlant qu'un classement général, car les performances varient selon la qualité des images, la langue, le type d'interface et la précision des questions.
Les recherches sur les architectures inspirées du vivant nourrissent aussi le débat autour de modèles plus efficaces et plus adaptatifs. Sakana AI et l'approche bio-inspirée proposent une autre façon de réfléchir à la composition, à l'évolution et à la coopération de systèmes d'intelligence artificielle. Ces pistes intéressent les équipes qui cherchent à réduire le gaspillage de calcul sans sacrifier la capacité de résolution sur des tâches complexes.
Des usages concrets pour le jeu vidéo et la création
Reka AI peut servir d'assistant d'analyse visuelle dans des contextes où les informations arrivent vite. Son intérêt n'est pas de remplacer le regard humain, mais de réduire le temps consacré aux tâches répétitives et de rendre un contenu plus accessible.
- Analyser un clip de gameplay : résumer les événements majeurs, relever une mécanique visible ou rechercher un passage précis dans une longue séquence.
- Documenter une interface : transformer des captures d'écran en brouillon de guide, avec les menus, indicateurs et actions observables.
- Préparer une modération : aider à trier des extraits soumis par une communauté, sous réserve d'une validation humaine.
- Faciliter l'accessibilité : générer des descriptions initiales d'éléments visuels ou aider à produire des sous-titres et des repères contextuels.
Un créateur peut, par exemple, envoyer une capture d'un écran de configuration et demander quels réglages sont visibles. Il peut ensuite demander une explication destinée à un public débutant. La qualité finale dépendra toujours de la précision des informations fournies et d'une relecture : une interface peut évoluer, certains libellés peuvent être tronqués, et une image seule ne révèle pas tout.
Comment évaluer un modèle multimodal dans la pratique ?
Comparer deux modèles sur une simple question ne suffit pas. Une évaluation utile repose sur un petit jeu de cas proches de votre usage réel : captures sombres, texte minuscule, scènes rapides, interfaces chargées, dialogues en français et demandes formulées de plusieurs façons.
| Critère | Question à poser | Exemple concret |
|---|---|---|
| Compréhension visuelle | Le modèle identifie-t-il correctement les éléments visibles ? | Reconnaître les jauges, objectifs et icônes d'une HUD. |
| Raisonnement temporel | Suit-il l'ordre des événements dans une vidéo ? | Repérer ce qui déclenche un échec dans un court clip. |
| Latence | Le délai convient-il à une interaction directe ? | Obtenir une première réponse durant une session de travail. |
| Fiabilité | Signale-t-il ses incertitudes ? | Admettre qu'un texte est trop flou pour être lu. |
Une bonne méthode consiste à conserver les erreurs les plus instructives. Si le modèle confond régulièrement des icônes proches, rate les textes affichés à faible résolution ou invente un détail absent, ces cas doivent rejoindre votre protocole de test. Ce sont les limites observées en situation qui comptent, pas seulement une démonstration soignée.
Ce que la recherche d'efficacité implique réellement
Parler de performance GPU ne signifie pas qu'un modèle doit toujours utiliser moins de ressources. Certaines demandes complexes exigent davantage de calcul, surtout lorsqu'elles portent sur de longues vidéos ou sur une comparaison détaillée de plusieurs documents. Le vrai enjeu est d'utiliser la puissance matérielle au bon endroit.
Dans une architecture bien pensée, les opérations coûteuses sont réservées aux étapes qui apportent une valeur mesurable : compréhension d'un passage ambigu, croisement d'informations visuelles et textuelles, ou génération d'une réponse détaillée. Les traitements plus simples peuvent être confiés à des modèles plus légers ou à des filtres préparatoires.
Cette répartition ressemble à une équipe de montage : personne ne visionne chaque image avec la même attention, mais les moments décisifs sont examinés de près. Pour l'IA, ce choix influence directement la réactivité du service, son coût de fonctionnement et la possibilité de proposer une expérience fluide à grande échelle.
À mesure que les interfaces intégreront davantage d'images, de captures, de clips et de documents, les modèles comme ceux de Reka AI seront jugés sur un équilibre très concret : comprendre correctement, répondre assez vite et reconnaître honnêtement ce qu'ils ne peuvent pas déduire.
Questions fréquentes
Qu'est-ce que Reka AI ?
Reka AI est une entreprise qui développe des modèles d'intelligence artificielle multimodaux, capables de traiter du texte et des contenus visuels comme les images ou les vidéos.
Que signifie IA multimodale ?
Une IA multimodale peut analyser plusieurs types de données dans le même échange. Elle peut, par exemple, répondre à une question écrite portant sur une capture d'écran ou une séquence vidéo.
Pourquoi les GPU sont-ils essentiels pour ces modèles ?
Les GPU exécutent efficacement de nombreux calculs en parallèle, ce qui accélère l'entraînement et l'inférence des réseaux de neurones. Cette puissance est particulièrement utile pour traiter des images et des vidéos. [ A lire en complément ici ]
Reka AI peut-il analyser du gameplay ?
Un modèle multimodal peut analyser des captures et des clips de gameplay pour décrire des éléments visibles, résumer des actions ou répondre à des questions ciblées. Les résultats doivent être vérifiés, surtout lorsque l'image est floue ou l'action très rapide.
La performance GPU signifie-t-elle seulement une réponse plus rapide ?
Non. Elle influence aussi le coût de traitement, le nombre de demandes pouvant être prises en charge simultanément et la capacité à manipuler des contenus visuels plus riches sans dégrader l'expérience utilisateur.
Comment tester la qualité d'un modèle multimodal ?
Il faut utiliser des exemples proches de l'usage visé : interfaces complexes, images sombres, texte petit, séquences rapides et questions précises. Il est utile de noter les erreurs répétées pour comparer objectivement plusieurs modèles.
Un modèle multimodal peut-il se tromper sur une image ?
Oui. Il peut confondre des objets, mal lire un texte, interpréter incorrectement une action ou ajouter un détail non visible. Une validation humaine reste nécessaire pour les informations importantes ou sensibles.
👉 Lire aussi: Scrum Master : rôle et missions dans la méthode agile


A propos de nous : Pixelina RAM

Je suis Pixelina RAM, une exploratrice intrépide des mondes numériques et des pixels animés. Depuis toute petite, je me passionne pour les univers vidéoludiques, des classiques rétro aux dernières nouveautés indé. J’adore décortiquer la narration, analyser les mécaniques de jeu et partager mes coups de cœur insolites. Sur Elektrik Sheep, je vous invite à me suivre dans des aventures où la curiosité et l’émerveillement sont toujours au rendez-vous. Préparez vos manettes, on ne sait jamais où la prochaine quête nous emmènera !